Nyrenetværk: Brug af nyre-afledte genekspressionsdata til at forudsige og prioritere nye gener involveret i nyresygdom Ⅰ
Aug 07, 2023
Gentest hos patienter med mistanke om arvelignyre sygdomafslører muligvis ikke den genetiske årsag til lidelsen, da potentielt patogene varianter kan findes i gener, der endnu ikke vides at være involveret inyre sygdom. Vi har udviklet Kidney Network, som anvender vævsspecifik ekspression til at informere om kandidatgenprioritering specifikt for nyresygdomme. KidneyNetwork er en ny metode konstrueret ved at integrere et nyre-RNA-sekventerende co-ekspressionsnetværk på 878 prøver med et multivævsnetværk på 31.499 prøver. Den bruger ekspressionsmønstre og etablerede gen-fænotype-associationer til at forudsige, hvilke gener der kan relateres til hvilke (sygdoms-)fænotyper på en upartisk måde. Vi anvendte KidneyNetwork på sjældne varianter i exome-sekventeringsdata fra 13 nyresygdomspatienter uden en genetisk diagnose for at prioritere kandidatgener. KidneyNetwork kan nøjagtigt forudsige nyre-specifikke genfunktioner og (nyresygdom) fænotyper for sygdomsassocierede gener. Skæringspunktet mellem prioriterede gener og gener, der bærer sjældne varianter, i en patient med nyre- og levercyster identificerede ALG6 som et plausibelt kandidatgen. Vi styrker denne plausibilitet ved at identificere ALG6-varianter i flere tilfælde af cystisk nyre og leversygdom uden alternative genetiske forklaringer. Vi præsenterer KidneyNetwork, et offentligt tilgængeligt nyrespecifikt co-ekspressionsnetværk med optimerede gen-fænotype-forudsigelser for nyresygdomsfænotyper.

Vi har designet en brugervenlig onlinegrænseflade, der gør det muligt for klinikere og forskere at bruge genekspression og samreguleringsdata oggen-fænotype-forbindelser for at fremskynde fremskridt inden for arvelig nyresygdomsdiagnose og forskning.
OVERSÆTTELSESUDTALELSE:Gentest hos patienter med mistanke om arvelignyre sygdomafslører muligvis ikke den genetiske årsag til patientens lidelse. Potentielt patogene varianter kan ligge i gener, der endnu ikke vides at være involveret i nyresygdom, hvilket gør det vanskeligt at fortolke relevansen af disse varianter. Dette afslører et klart behov for metoder til at forudsige de fænotypiske konsekvenser af genetisk variation på en upartisk måde. Her beskriver vi KidneyNetwork, et værktøj, der udnytter vævsspecifik ekspression til at forudsige nyrespecifikke genfunktioner. Anvendelse af KidneyNetwork på en gruppe udiagnosticerede tilfælde identificerede ALG6 som et kandidatgen i cystisk nyre oglever sygdom. Sammenfattende kan KidneyNetwork hjælpe med fortolkningen af genetiske varianter og kan derfor være af værdi i translationel nefrogenese og hjælpe med at forbedre det diagnostiske udbytte hos nyresygdomspatienter.

KLIK HER FOR AT FÅ CISTANCHE TIL NYRESYGDOM
INTRODUKTION
Gentest hos patienter med mistanke om arvelig nyresygdom kan afsløre forårsagende patogene varianter inyre-relaterede gener. Men i mange tilfælde kan en genetisk årsag endnu ikke påvises. Patogene varianter i kendte nyrerelaterede gener påvises hos cirka 10-30 procent af genetisk testede patienter med kronisk nyresygdom af enhver årsag [1-3]. Disse procenter er dog sandsynligvis undervurderinger af antallet af patienter med en monogen årsag, da varianter i gener, der endnu ikke er impliceret i nyresygdom, vil forblive ubemærket. Potentielt skadelige varianter kan befinde sig i disse gener, hvilket gør det vanskeligt at prioritere og fortolke relevansen af disse varianter. Derfor er en af hovedudfordringerne efter et negativt diagnostisk resultat i kendte gener i den nuværende æra af genomisk medicin at opdage og prioritere nye kandidatgener med potentielt patogene varianter, der kan forklare patientens sygdom [4].
RNA-sekventeringsdata kan bruges til at forudsige kandidatsygdomsgener[5]. Vi har for nylig udviklet GeneNetwork og GeneNetwork-Assisted Diagnostic Optimization (GADO)-metoden til at prioritere nye kandidatsygdomsgener baseret på RNA-sekventeringsdata [6]. Tanken bag denne metode er, at visse sjældne lidelser kan være forårsaget af varianter i flere gener. Selvom disse gener er forskellige, har de normalt lignende biologiske funktioner. Når man studerer genekspressionsdata fra et stort antal prøver, viser disse sygdomsgener normalt stærk co-ekspression [6]. Hvis der er andre gener, der er stærkt co-udtrykt med kendte sjældne sygdomsgener, er det således muligt, at varianter i disse andre gener også kan forårsage den samme sygdom.
For at denne form for værktøj skal fungere optimalt, skal informationen om co-ekspression være så nøjagtig som muligt. Til GADO byggede vi et gen-co-ekspressionsnetværk baseret på offentligt tilgængelige RNA-sekventeringsdatasæt fra mange forskellige væv og brugte dette netværk til at forudsige, hvilke gener der kunne forårsage sjældne sygdomme. Disse forudsigelser blev trænet ved hjælp af den humane fænotype ontologi (HPO) database [7]. I HPO-databasen tildeles gener til fænotyper - kaldet HPO-termer - der er baseret på gen-sygdomsannotationer og sygdomssymptomer til stede i OMIM [8] og Orphanet [9] databaserne. Ved at integrere informationen fra HPO-databasen med gen-co-ekspressionsnetværket kunne vi beregne forudsigelsesscore for hvert gen pr. HPO-term. Tilsammen udgør disse scoringer GeneNetwork. GADO prioriterer derefter gener ved at kombinere en inputliste af HPO-termer, der beskriver patientens fænotype, med en liste over gener med mulige skadelige varianter fra den pågældende patient. Prioriteringen af genlisten er baseret på de kombinerede genforudsigelsesscore for input HPO-termer [6].
Fordi vi observerede, at GeneNetworks forudsigelsespræstation for nyrerelaterede HPO-fænotyper var begrænset, forsøgte vi at forbedre forudsigelsen ved at udvikle et nyrespecifikt netværk. Vi gjorde dette ved at bruge 878 nyre-RNA-sekventeringsprøver, som vi berigede med et eksisterende datasæt på 31.499 prøver fra andre væv [6]. Ved at udvikle en ny forudsigelsesalgoritme, der kan veje den information, der er til stede i begge datasæt, forbedrede vi ydeevnen for nyrerelaterede veje. I dette papir præsenterer vi det resulterende KidneyNetwork, et co-ekspressionsnetværk, der kan bruges til nøjagtigt at forudsige gen-fænotype-associationer af gener, der er ukendte for nyre-relaterede HPO-termer. Som bevis på princippet anvendte vi KidneyNetwork til at eksome sekventeringsdata fra en gruppe patienter med tidligere uløste nyresygdomme.
METODER
For at forbedre forudsigelsen af nyre-relaterede fænotyper indsamlede vi nyre-afledte RNA-sekventeringsdata, opdaterede GeneNetwork med nyere referencedatabaser og forbedrede statistiske analyser, efterfulgt af integration af vævsspecifik information.
Datasæt i KidneyNetwork
RNA-sekventeringsdata fra udvalgte nyreprøver af flere oprindelser, herunder primært, tumor- og føtalt væv, blev kombineret med et eksisterende datasæt af multi-tissue RNA-sekventering brugt som grundlaget for vores tidligere beskrevne GeneNetwork [6] (tabel S1, S2) . Vi valgte at inkludere multivævsdatasættet af to grunde. For det første havde vi brug for et tilstrækkeligt antal prøver til at bygge et basisnetværk. For det andet ønskede vi at bevare ekspression, der er specifik for flere eller alle nyrecelletyper, men ikke for andre væv. Vi gjorde dette, fordi gen-fænotype-score er baseret på forskelle i ekspression mellem prøver; hvis alle gener har høj (eller lav) ekspression i alle prøverne inkluderet i analysen, vil de ikke tilføje tilstrækkelig information til forudsigelsesalgoritmen. Multivævsdatasættet af humane RNA-sekventeringsprøver, der blev brugt til at udvikle GeneNetwork, blev genbrugt og behandlet som beskrevet tidligere [6]. Efter forbehandling indeholdt dette datasæt 31.499 prøver og 56.435 gener.
3.194 nyre-afledte RNA-sekventerede prøver blev downloadet fra European Nucleotide Archive (ENA) og Genotype-Tissue Expression (GTEx) Project (Note S1). Forbehandling af nyredatasættet blev udført på samme måde som multivævsdatasættet [6] (Note S2, Note S3). Efter prøve- og genudvælgelse var der 58.283 gener og 878 nyreprøver tilbage. Vi undersøgte de resterende 878 RNA-sekventeringsprøver ved hjælp af UMAP klyngealgoritmen (Note S4).
HPO filtrering. Til konstruktionen af KidneyNetwork brugte vi gen-fænotype-associationer fra HPO-databasen [7] version 1268. I HPO-databasen er annotering af gener til HPO-definerede fænotyper baseret på gen-sygdomsannotationerne i OMIM [8] morbid. map (downloadet 26. marts 2018) og Orphanet [9] "en_product6.xml" fil version 1.3.1. Gensygdomsannotationer i disse databaser kan være baseret på flere faktorer, herunder statistiske associationer og storskala kopiantal variationer. Vi ønskede at træne KidneyNetwork ved kun at bruge gener, for hvilke sammenhængen mellem genet og den sjældne sygdom er veletableret. Derfor udelukkede vi de multigene syndromer, da det ofte ikke er klart, hvilke af generne i kopinummervarianterne, der bidrager til hvilke fænotyper. Vi udelukkede også rene modtagelighedsgener (Bemærk S5).
Normalisering af udtryk. Efter prøve- og genkvalitetskontrol (QC) blev ekspressionsmatrixen af de resterende prøver og gener log2- transformeret, og gental blev normaliseret ved hjælp af DESeq efter median-of-ratio-metoden. Vi korrigerede derefter genekspressionsdataene for kovariater (Bemærk S6).

Nedbrydning
Efter filtrering og QC af hele datasættet var næste trin at udføre en dekomponering for at beregne egenvektorerne for datasættet (Note S7). For både GeneNetwork og det genregulerende netværk baseret på nyre-afledte data definerede vi det optimale antal komponenter (Note S8). De første 165 egenvektorer for GeneNetwork og de første 170 egenvektorer for de nyre-afledte data blev identificeret og slået sammen til en større matrix indeholdende alle 335 egenvektorer.
Gen-HPO-term scoreberegning Gen-fænotype scoreberegningen blev udført i flere trin (fig. S5). Først udførte vi en logistisk regression ved hjælp af de kombinerede egenvektorer og gen-fænotype-annotationsfilen som input. Vi brugte de resulterende værdier og egenvektorscorerne til at beregne en genlog-oddsscore for hvert gen i hver egenvektor (Bemærk S9).

For at undgå overtilpasning af genlog-odds-scores af allerede annoterede gener, anvendte vi en leave-one-out krydsvalideringstilgang (Note S10). Log-oddsene blev efterfølgende oversat til gen-z-scores ved hjælp af en permuteret nulfordeling for hver fænotype (Note S11).
For at bestemme forudsigelsesnøjagtigheden beregnede vi arealet under ROC-kurven (AUC). AUC blev beregnet pr. HPO-term under anvendelse af de forudsagte gen-z-scores og kendte annotationer. Betydningen af forudsigelserne blev beregnet ved hjælp af den tosidede Mann-Whitney rangtest. Efter Bonferroni-korrektion blev en forudsigelse betragtet som signifikant ved p < 0.05.
Sammenligning af forudsigelsesydelse
Vi sammenlignede forudsigelsesydelsen af fire forskellige netværk: (1) det originale GeneNetwork, (2) det opdaterede GeneNetwork, (3) det nyrespecifikke genregulerende netværk udelukkende baseret på nyre-afledte prøver og endelig (4) KidneyNetwork, som kombinerer de to sidstnævnte. Kvaliteten af HPO-forudsigelserne lavet af disse netværk blev vurderet baseret på AUC for hver nyre-relateret fænotype (tabel S3). Forbedret kvalitet af et netværk blev defineret som forbedret forudsigelsesnøjagtighed for nyre-relaterede termer, der var signifikant forudsagt i hver sammenligning af to netværk og ved et øget antal signifikant forudsagte nyre-relaterede termer. Betydningen af forbedring i forudsigelsesnøjagtighed af et netværk versus et andet blev vurderet ved hjælp af DeLong-testen [10] integreret i pROC R-pakken [11].
Anvendelse af KidneyNetwork til 13 patienter med mistanke om arvelig nyresygdom En af anvendelserne af KidneyNetwork er at prioritere kandidatgener hos patienter med uløst nyresygdom. For at evaluere denne kliniske applikation brugte vi KidneyNetwork til at prioritere kandidatgener for patienter med forskellige nyresygdomme ved hjælp af GADO-metoden [6]. GADO kombinerer genforudsigelse z-scores gengivet gennem KidneyNetwork for et givet sæt af HPO termer. Gener med en kombineret z-score større end eller lig med 5 for det unikke sæt af HPO-termer forbundet med hver patient blev betragtet som potentielle kandidatgener for den pågældende patient.
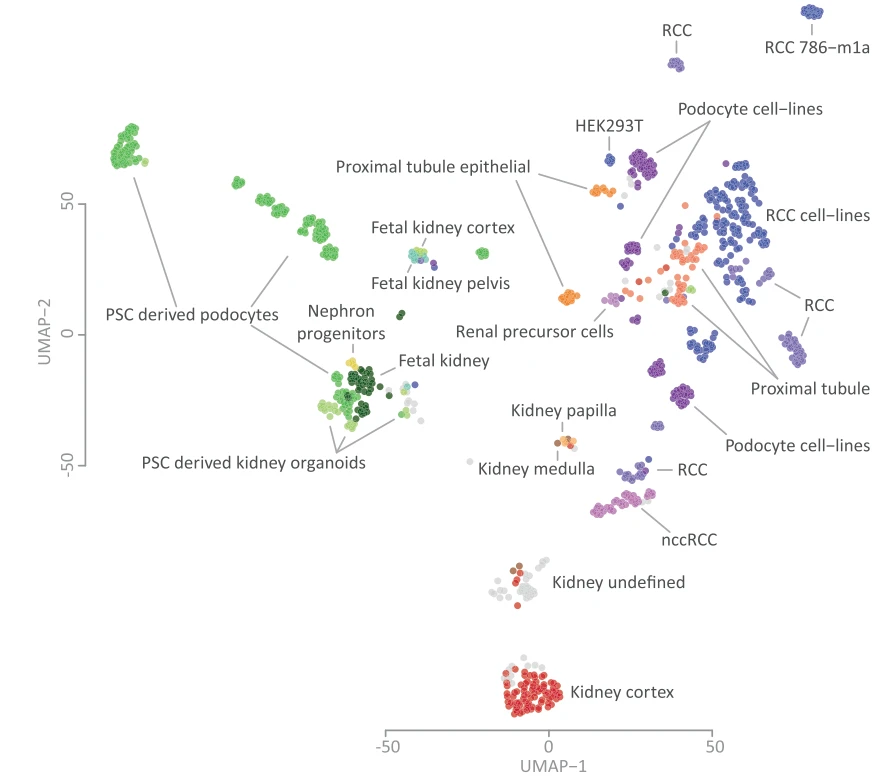
Fig. 1 UMAP-visualisering af de nyre-afledte ekspressionsdata. 878 prøver blev grupperet i tre hovedklynger: sundt primært væv (midten og bunden), udviklingsprøver (venstre) og nyrecellekarcinom (RCC) prøver (højre). På venstre side af figuren kan grupperingen af pluripotente stamcelle (PSC)-afledte podocytter og PSC-afledte organoider med primære føtale prøver og nefron-progenitorceller ses. På højre side klynger RCC-prøver tæt på proksimale tubuliprøver, og RCC-klyngen tættest på sunde primære vævsprøver består af ikke-klare celle RCC (nccRCC) prøver. I midten og i bunden klynger sunde primære nyreprøver sig baseret på deres oprindelsesvæv.
De 13 patienter inkluderet i undersøgelsen var alle mistænkt for at have monogen nyresygdom, men havde ingen genetisk diagnose (Note S12). HPO-termer blev tildelt disse tilfælde baseret på deres fænotype. For hver patient blev de komplette exome-sekventeringsdata analyseret ved hjælp af CAPICE [12] for at identificere potentielt patogene varianter. Gener indeholdende varianter med en GnomAD Popmax filtrerende AF [13]<0.005 and a recall ≥99%, corresponding with a mild CAPICE cut-off of ≥0.0027, were considered interesting candidates.
Overlapning af generne identificeret af KidneyNetwork-integrationen i GADO med generne identificeret af CAPICE resulterede i en liste over gener for hver patient. Disse gener og varianter i disse gener blev manuelt gennemgået af et nefrogenese-ekspertpanel (AMvE, LRC, NVAMK) for deres patogenetiske potentiale baseret på befolkningsmålinger, forudsigelsesværktøjer, tilgængelig litteratur og segregation (Note S13). For det resulterende kandidatgen blev yderligere patienter, der bar varianter i det samme gen, identificeret via samarbejdspartnere og 100,000 Genomes Project [14]. GeneMatcher-værktøjet [15] blev også brugt og gav ingen yderligere patienter frem til den 15. februar 2023.
Identifikation af yderligere patienter Den tidligere beskrevne uløste polycystiske nyre- og leversygdomskohorte [16] blev brugt til at vurdere sjældne varianter (Note S14). Vi brugte Fishers eksakte test til at sammenligne hyppigheden af identificerede variant(er) med den europæiske delmængde af ikke-finske europæere i gnomAD-databasen [17]. Desuden brugte vi 100,000 Genomes Project [14] til identifikation af yderligere patienter baseret på den eller de identificerede variant(er) (Bemærk S15).

RESULTATER
Datahentning og prøveklyngning Vi udvalgte 878 nyreprøver (fig. S2), som vi grupperede og plottede ved hjælp af UMAP-algoritmen (fig. 1). Generelt klynger dataene sig i tre hovedklynger: primære ikke-tumornyredata, nyreudviklingsprøver og prøver af proksimale tubuli, glomerulus og nyrecellecarcinom (RCC).
KidneyNetwork forbedrer gen-fænotype-forudsigelser. Først opdaterede vi GeneNetwork med den opdaterede HPO-database (fig. S6) og optimerede gennetværkets bygningspipeline (fig. S7). Disse ændringer gav en forbedring i det generelle GeneNetwork sammenlignet med den tidligere version (Fig. S8). Vi brugte derefter den forbedrede pipeline til at bygge det nyrespecifikke genregulerende netværk. Som forventet, givet den lille prøvestørrelse, klarede denne version af det nyrespecifikke netværk sig mindre godt end GeneNetwork (fig. S9). Efterfølgende gav kombinationen af GeneNetwork og det nyrespecifikke gen-co-ekspressionsnetværk i KidneyNetwork vores bedste resultater for nyrerelaterede HPO-udtryk (Fig. 2A; Tabel S5). Forudsigelse af AUC, præcision, følsomhed og f1-score for hver forudsagt vej er angivet (tabel S6)
To eksempler på forbedrede nyre-relaterede HPO-termer er hypomagnesæmi og tubulointerstitiel abnormitet (fig. 2B). Visualisering af disse fænotyper i tæthedsplot viser højere prioritering af z-scores for kendte sygdomsrelaterede gener sammenlignet med ikke-annoterede gener. For ukendte gener gælder det, at jo højere forudsigelsens z-score er, jo mere sandsynligt er det, at de er et kandidatsygdomsgen. Visualisering af geninteraktionsnetværkene for kendte sygdomsgener baseret på forudsigelsesscorerne viser igen stigningen i antallet og styrken af interaktioner opnået ved hjælp af KidneyNetwork sammenlignet med GeneNetwork.
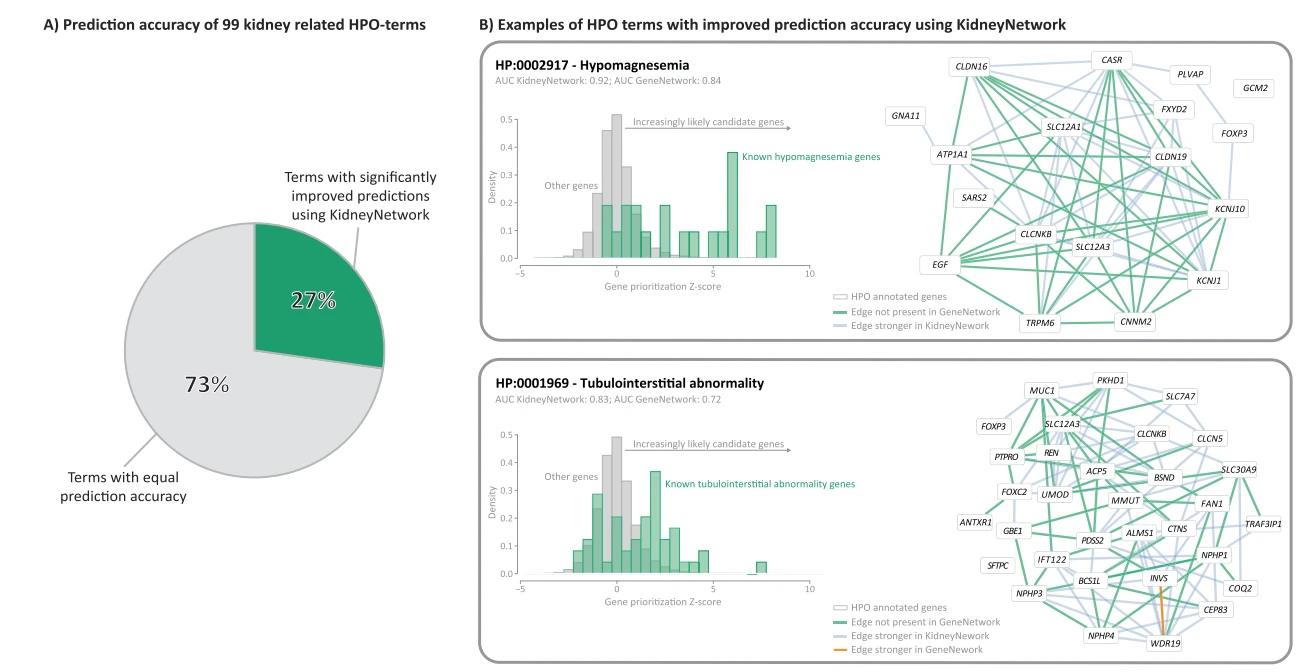
Fig. 2 KidneyNetwork yder bedre for nyrerelaterede HPO-udtryk end det opdaterede GeneNetwork. 27 procent af de nyrerelaterede fænotyper forudsiges væsentligt bedre ved brug af KidneyNetwork sammenlignet med GeneNetwork. B Densitetsplot af genforudsigelsesscorerne inden for to af de mest forbedrede fænotyper, hypomagnesæmi og tubulointerstitiel abnormitet, viser højere forudsigelsesværdier for generne annoteret for fænotypen og forudsiger også potentielle ukendte kandidatgener. Netværkene forudsagt ved hjælp af KidneyNetwork viser flere og stærkere sammenhænge mellem de kommenterede gener end netværkene forudsagt ved hjælp af GeneNetwork.
Vi så også en stigning i antallet af signifikante forudsagte nyrerelaterede HPO-termer for KidneyNetwork (n=71) sammenlignet med GeneNetwork (n=63). Dette fik os til at antage, at KidneyNetwork forudsiger nyre-relaterede termer med højere nøjagtighed generelt og derfor er i stand til at forudsige flere nyre-relaterede fænotyper med højere signifikans. En parret t-test viser, at HPO AUC-score generelt var signifikant bedre for KidneyNetwork versus GeneNetwork (gennemsnitlig AUC: 0.76 versus 0.74; t-test p-værdi: 4,5 × 10 -8). Dette resultat tyder på, at KidneyNetwork forudsiger flere nyrespecifikke HPO-termer med en højere forudsigelsesnøjagtighed end GeneNetwork.
KidneyNetwork prioriterer ALG6 som et kandidatsygdomsgen hos patienter med nyrecyster og levercyster For at undersøge den kliniske anvendelighed af KidneyNetwork prioriterede vi gener for 13 patienter med en formodet arvelig nyresygdom, men ingen genetisk diagnose og gennemskærede disse med gener, der indeholder potentielt patogene varianter. De resulterende genlister indeholdt 1‒4 kandidatgener for 9 af de 13 patienter (tabel S7). Hos en patient (SAMPLE6) identificerede manuel behandling af denne liste ALG6 (ALG6 alpha-1,3-glucosyltransferase) som et potentielt kandidatgen til at forklare patientens nyre- og levercyster (fig. 3). Den kombinerede z-score for ALG6 for de imputerede HPO-termer var signifikant i KidneyNetwork efter multiple testkorrektion (z=5.43). Dette gen ville være gået glip af, hvis vi havde brugt GeneNetwork: der nåede ALG6 ikke signifikansgrænsen for z-score større end eller lig med 5.

ALG6 som et kandidatgen for patienter med nyre- og levercyster. ALG6-varianten c.680 plus 2 T > G båret af SAMPLE6 er heterozygot. Dette er en kendt patogen splejsningsstedvariant, der resulterer i medfødt glykosyleringsforstyrrelse (CDG) type Ic, når patogene varianter er til stede på begge alleler [18, 19]. ALG6 minder stærkt om ALG8, som har været impliceret i nyre- og levercystefænotyper [20], og ifølge KidneyNetwork er ALG6 og ALG8 stærkt co-regulerede (z-score=8.59).
I betragtning af denne biologiske plausibilitet forespurgte vi en kohorte på 120 ikke-relaterede tilfælde af polycystisk nyre- og leversygdom for sjældne varianter, MAF < 0.001, i ALG6. Denne kohorte er mindre opdateret, da den tidligere blev beskrevet og er blevet udelukket ved exome-sekventeringsanalyse for tab af funktionsmutationer eller rapporterede patogene ikke-trunkerende varianter i PKD1, PKD2, PRKCSH, SEC63, GANAB, ALG8, ALG9, SEC61B, PKHD1 eller DNAJB11 [16]. Tre ikke-relaterede tilfælde (YU372, YU378, YU481) bar sjældne ALG6-varianter; hver havde den samme ALG6 c.257 plus 5 G > En ikke-kanonisk splejsningsvariant kendt for at være patogen for ALG6-CDG og splejsningsændrende in vitro [19, 21]. På trods af en delt mutation rapporterede disse tre tilfælde hver især, at ingen kendte berørte familiemedlemmer var tilmeldt fra forskellige stater på tværs af USA og er ikke relateret til den bedste grænse for detektion ved brug af VCFtools relatedness2-algoritmen med Relatedness_PHI < 0,005.
I betragtning af repræsentationen af denne variant i tre tilfælde af europæisk herkomst i denne fænotypisk definerede kohorte, sammenlignede vi dens frekvens i den europæiske delmængde af tilfælde (n=105) med ikke-finske europæere i gnomAD [17] med dækning kl. denne position (n=64,466) [17]. I patientkohorten indeholdt 3 ud af 210 alleler denne variant, mens den i gnomAD, en kohorte, der ikke var udvalgt med hensyn til nyre- eller levercystebyrde, blev fundet i 121 ud af 128.932 alleler. Denne ca. 10-fold berigelse er statistisk signifikant ved Fishers eksakte test, p=0.0011. Denne mutation var også tilbagevendende i tilfælde af ALG6-CDG [19].
Vi undersøgte også de 100,000 Genomes Project-datasæt [14] og kontaktede samarbejdspartnere, som identificerede tre yderligere data til anvendelse på nyresygdomme. En betydelig del af patienter med mistanke om genetisk nyresygdom forbliver uden en genetisk diagnose, da lister over sygdomsgener for mange tilstande er ufuldstændige. At identificere, hvilke gener der er involveret i nyresygdom, er afgørende for at forbedre det diagnostiske udbytte hos nyresygdomspatienter og for at studere sygdomspatogenese for at nærme sig behandlingsmuligheder. Etablering af nye sygdomsgener kræver omhyggelig biologisk validering. Det er afgørende at implicere gener, der er værdige til sådanne undersøgelser. Anvendelse af KidneyNetwork i forbindelse med WES- eller GWAS-data af nefrologer, kliniske genetikere eller forskere vil hjælpe hver af disse grupper med at deltage i genimplikation. KidneyNetwork kombinerer et co-ekspressionsnetværk baseret på et nyreprøvedatasæt med det tidligere publicerede multivævsdatasæt, der bruges til at bygge GeneNet-arbejde. Kombinationen af datasættene i KidneyNetwork forbedrede fænotypeforudsigelser relateret til nyresygdom sammenlignet med netværk baseret på de to datasæt separat. Som et principbevis viser vi, at kandidatgenlisten for den kombinerede fænotype af nyre- og levercyster genereret af KidneyNetwork prioriterede en håndterbar liste af kandidatgener fra en lang liste af gener indeholdende sjældne varianter hos vores patient med denne fænotype.
Vi undersøgte også de 100 000 Genomes Project-datasæt [14] og kontaktede samarbejdspartnere, som identificerede tre yderligere patienter med nyre- og/eller levercyster, der bærer en heterozygot potentielt skadelig variant i ALG6, uden en alternativ genetisk forklaring.
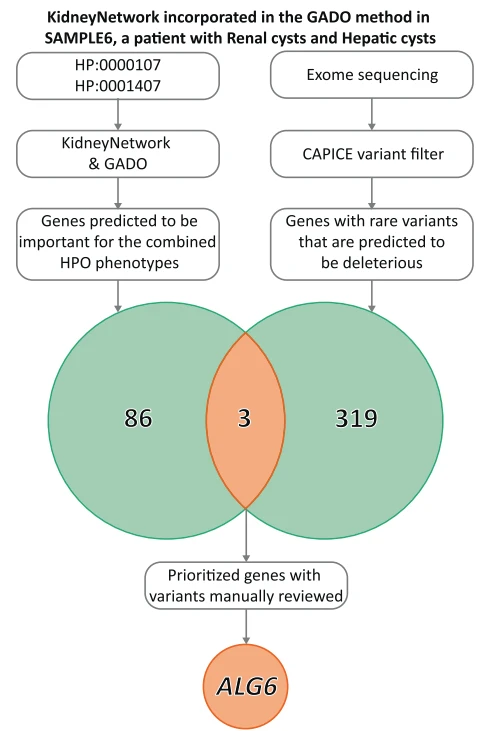
Fig. 3 NyreNetværk indarbejdet i GADO-metoden i SAMPLE6, en patient med nyre- og levercyster. 89 kandidatgener ud af alle gener blev prioriteret af KidneyNetwork ved hjælp af GADO, baseret på HPO-begreberne "Nyrecyster" (HP:0000107) og "Levercyster" (HP:0001407). Exome-sekventeringsdatafortolkningsmetode CAPICE gav 322 gener indeholdende potentielt patogene varianter i patientens exome-sekventeringsdata. Ved overlapning af disse genlister blev tre gener identificeret, der opfyldte selektionskriterierne, hvoraf det ene var ALG6.
I alt identificerede vi syv patienter med kendte splejsningsstedvarianter, der blev rapporteret at være sygdomsfremkaldende hos alvorligt ramte CDG-patienter efter homozygositet eller sammensat heterozygositet og en patient med en sandsynlig patogen splejsningsstedvariant (tabel 1). I modsætning til de alvorligt angrebne ALG6-CDG-patienter (med involvering af flere organer, herunder udviklingsforsinkelse og flere neurologiske symptomer), præsenterede vores patienter en fænotype af multiple nyrecyster og/eller levercyster (fig. 4) . Mens PCLD kan være omfattende, ser nyrefænotypen ud til at være mild uden rapporteret eGFR-fald på trods af høj alder (dvs. en patient er i trediverne, de andre er mellem 45 og 80 år). Desuden fandt vi, at ALG6-varianten adskilte sig i nogle få familiemedlemmer, der også var påvirket (tabel 1; fig. 4).
Understøttende service:
E-mail:wallence.suen@wecistanche.com
Whatsapp/Tlf: plus 86 15292862950
Butik:
https://www.xjcistanche.com/cistanche-shop